
Láká to hodně. Nainstalujete pár doplňků z GitHubu, Claude Code bude stát o polovinu méně a na pětihodinový limit předplatného zapomenete. Autoři slibují úspory od 20 do 98 %, sociální sítě jsou plné sestav, které si „limit nikdy nevyčerpají“. Jak to, že tenhle zázrak výrobci neimplementují? Seznámím vás s nejznámějšími zástupci „spořičů promptů“ a hlavně s tím, jak obstály v mých testech…
Před pár dny mi na síti vyskočil typický příspěvek: Claude Code, k tomu Ponytail, Caveman, Headroom, Context Mode, Opus na plánování, Sonnet na práci a pointa „na pětihodinový limit úplně zapomínám“. Pod tím komentáře s dalšími doplňky, které „ještě přidají“. Zázrak, za 20 USD měsíčně naprogramujete cokoliv. Proč to tedy není v Claude Code od výrobce? Opravdu z nás jen tahají peníze, nebo je to AI slop? Podle svého hesla „tvrzení bez benchmarku je jen názor“ jsem se rozhodl situaci zmapovat a prompt kompresory otestovat.
Postavil jsem samostatný test na skutečném projektu (3gpp-explorer.com, TypeScriptové monorepo), pět nejčastěji doporučovaných doplňků jsem pustil proti čistému Claude Code a každý běh nechal zkontrolovat skrytými testy a nezávislým review. Celý harness je veřejný, takže si ho můžete zopakovat s Claude Code a na vlastním repozitáři.
Takže, pojďme se bavit o úspoře tokenů…
Za co v Claude Code platíte
Většinu účtu tvoří kontext, který agent nese s sebou. Při každém tahu posílá Claude Code modelu celou dosavadní konverzaci: systémový prompt, definice nástrojů, váš CLAUDE.md, přečtené soubory, výstupy příkazů. Aby to nebylo drahé, ukládá se ten začátek do cache (mezipaměti na straně Anthropicu). První zápis do cache stojí u Sonnetu 5.5 4 USD za milion tokenů, každé další čtení jen 0,10 USD. Vlastní výstup modelu stojí 10 USD za milion.
Představte si to jako stěhování. Zápis do cache je naložení dodávky, čtení z cache je každá další jízda s už naloženým nákladem. Kdo jezdí krátce, platí hlavně nakládání.
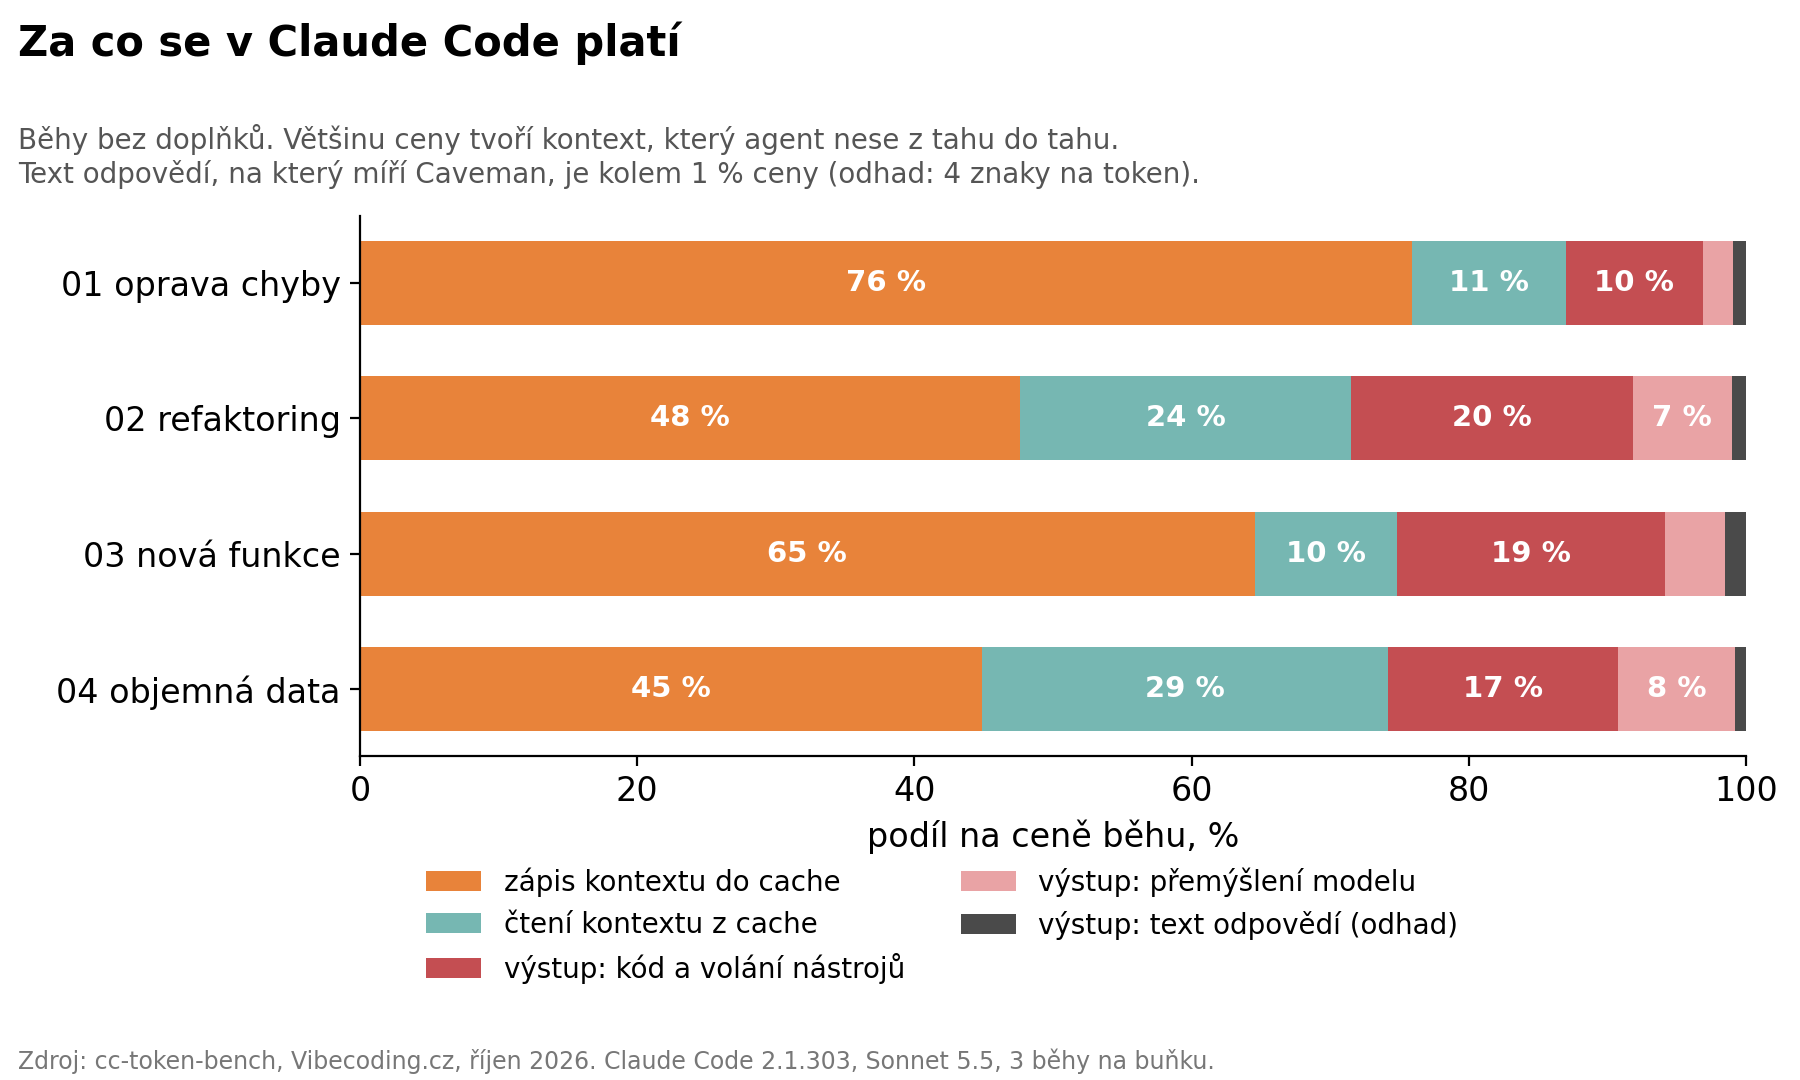
V mém měření tvořil zápis kontextu do cache 45 až 76 % ceny běhu, čtení dalších 10 až 29 %. Výstup modelu zbytek, a z toho text odpovědí, který čtete v terminálu, jen kolem 1 % ceny (je to můj odhad z počtu znaků). Většinu výstupu tvoří kód zapisovaný do souborů a přemýšlení modelu.
Tohle je klíč k celému článku. Doplněk, který zkracuje odpovědi, sahá na jedno procento účtu. Doplněk, který zkracuje výstupy příkazů, sahá na část kontextu, kterou si agent stejně často filtruje sám. A každý doplněk něco přidá do začátku každé relace, tedy přesně do té nejdražší položky. V tom je celý problém…
Které doplňky prošly testem
Pět doplňků, které se v doporučeních objevují nejčastěji:
- Caveman je skill (sada instrukcí pro agenta), který nutí Claude odpovídat telegraficky, jako jeskynní člověk. Slibuje kolem 68 % méně výstupních tokenů.
- Ponytail je skill, se kterým agent píše co nejméně kódu: napřed hledá hotové řešení ve standardní knihovně nebo v platformě. Slibuje −26 % ceny.
- RTK (Rust Token Killer) je malý program, který zachytí příkazy v shellu a zkrátí jejich výstup dřív, než ho agent přečte. Slibuje až 90 % méně výstupu ze shellu.
- Context Mode je MCP server (rozšíření s vlastními nástroji), který zpracuje velké výstupy v izolovaném procesu a do konverzace pustí jen shrnutí. Slibuje 98 % úsporu kontextu.
- Headroom je lokální proxy mezi Claude Code a API, která komprimuje celý kontext. Na předplatném smí jen bezztrátovou kompresi. Slibuje 21-57 % podle scénáře.
Čtyři úlohy ze skutečné historie projektu: krátká oprava chyby v API, refaktoring napříč deseti soubory, nová funkce se stránkou a oprava extrakce dat nad 40 MB HTML specifikací a JSON výstupů. Poslední úlohu jsem přidal dodatečně, aby RTK, Context Mode a Headroom dostaly hřiště, pro které jsou stavěné.
Každá kombinace úlohy a doplňku běžela třikrát, v náhodném pořadí, pokaždé v čistém kontejneru, se Sonnetem 5.5 na střední úrovni přemýšlení. Výsledek ověřovaly skryté testy, které agent neviděl, a dvojí review od Codexu, který nevěděl, jaký doplněk běžel. Celkem 72 běhů hlavního testu a 12 běhů pokusu s CLAUDE.md, v ceníkové hodnotě 35 USD (zhruba 800 Kč).
Sliby proti měření
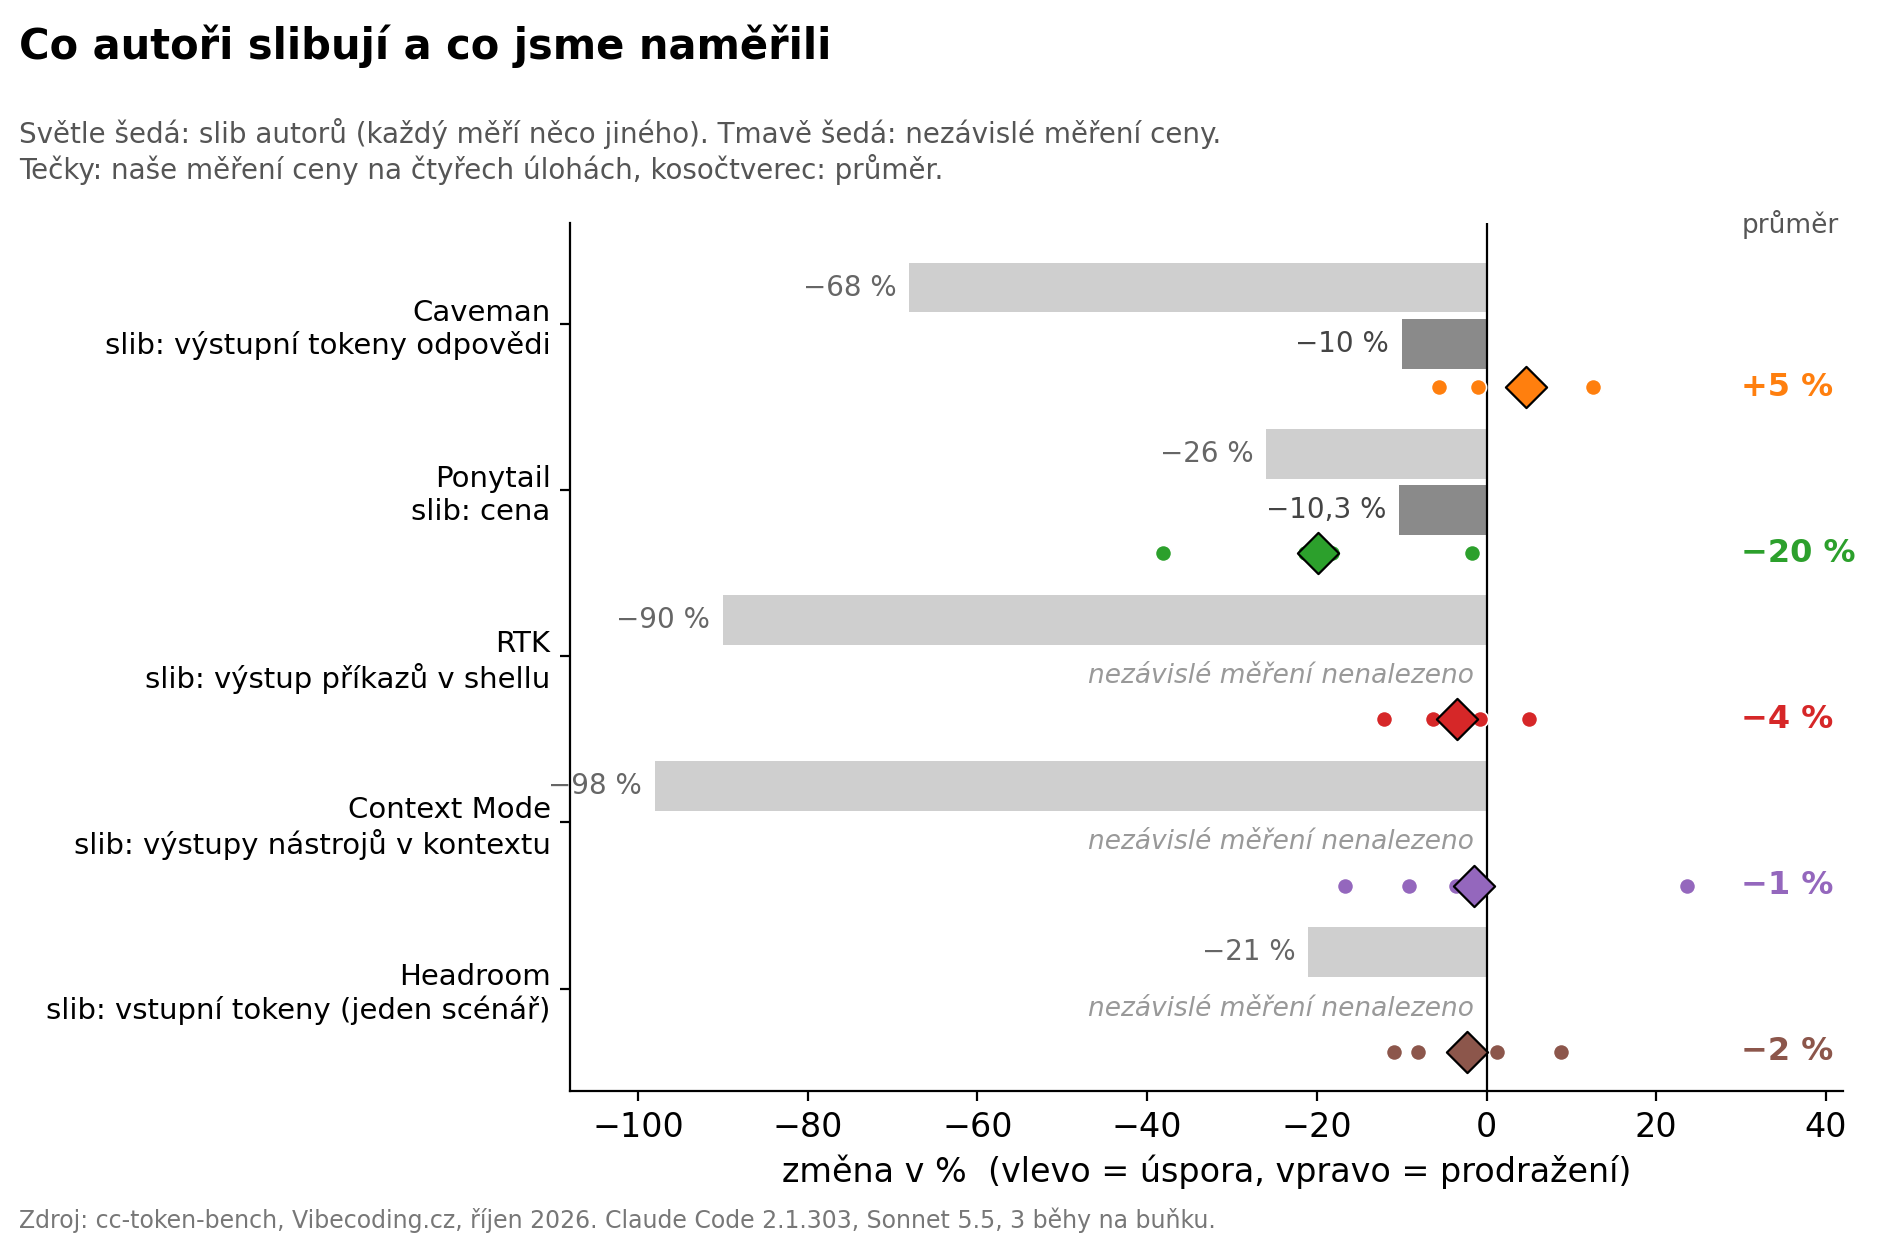
Pozor na jednu věc: sliby autorů měří každý něco jiného. Caveman výstupní tokeny, RTK výstup shellu, Context Mode objem dat v kontextu. Já měřím cenu, protože tu platíte (a limity předplatného se počítají ze stejných tokenů).
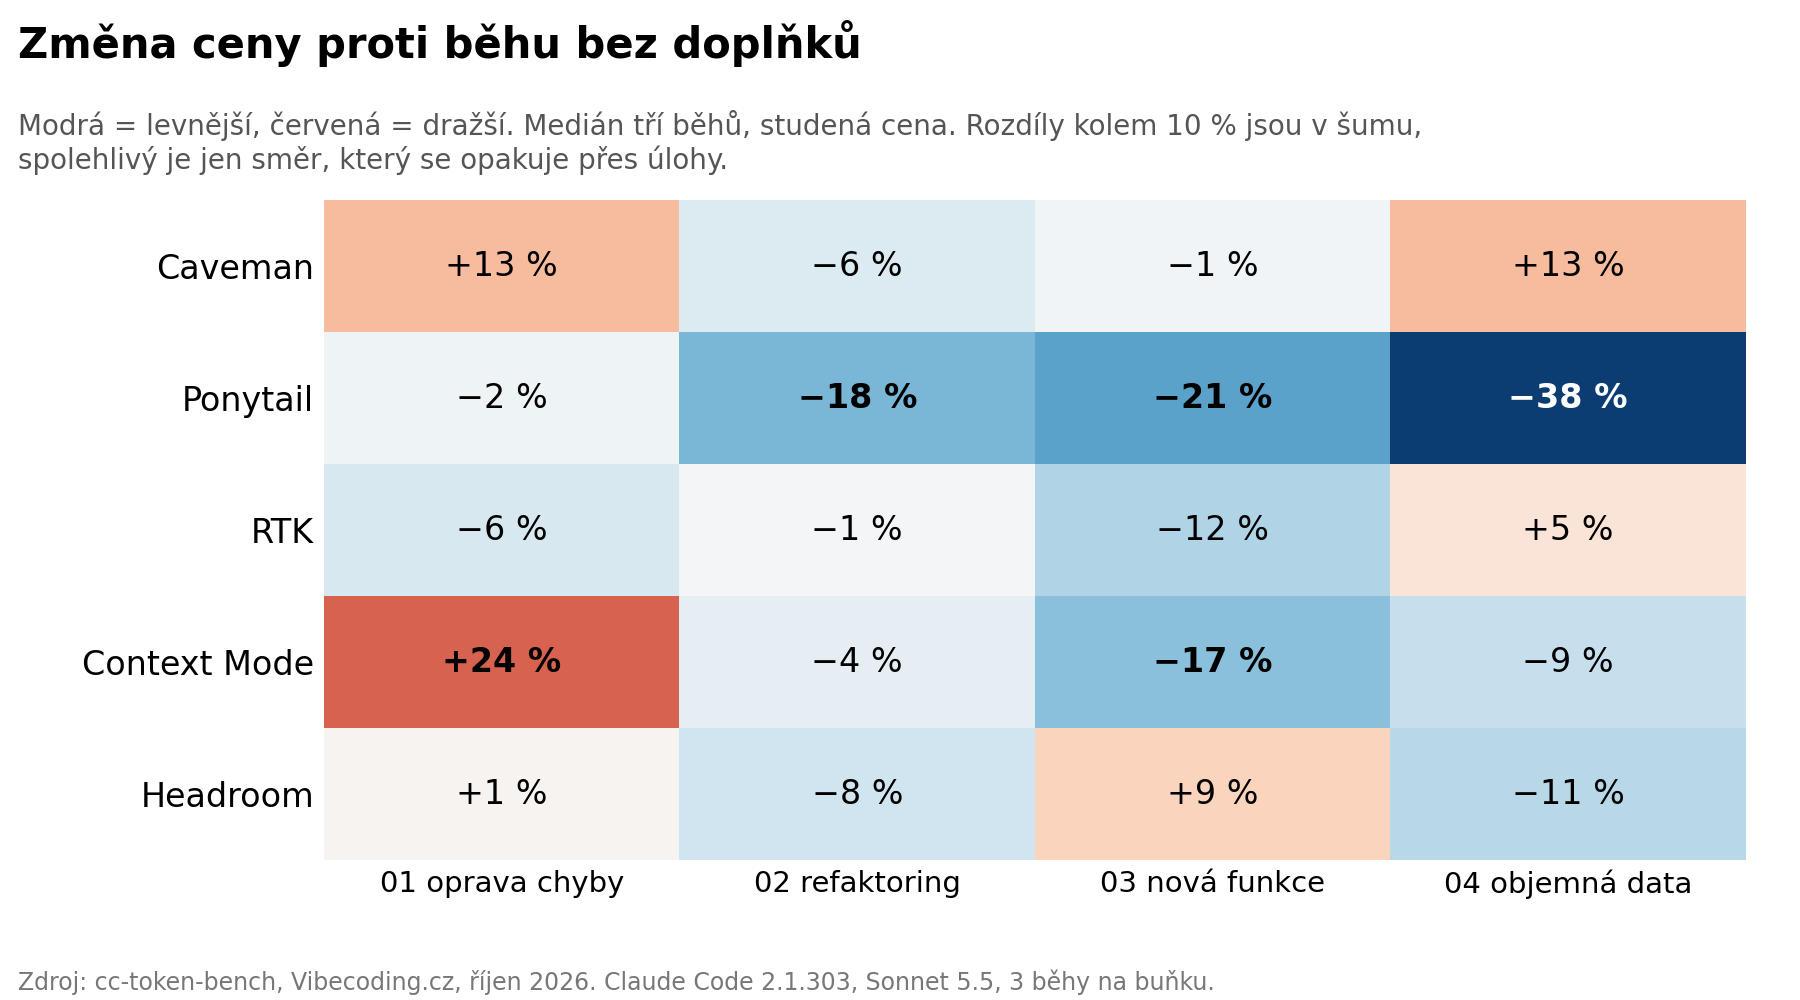
Čitelně a opakovaně ušetřil jen Ponytail. O 18 % na refaktoringu, o 21 % na nové funkci a o 38 % na úloze s velkými daty. Na krátké opravě chyby prakticky nic, tam není co zkracovat. Mechanismus je v datech vidět: agent napsal o pětinu až necelé dvě třetiny méně kódu, potřeboval méně tahů a méně toho přečetl. Odpovídá to i nezávislému testu JetBrains, který na 80 úlohách naměřil −10 % ceny.
Ostatní čtyři doplňky cenu v průměru nezměnily. Caveman +5 %, RTK −4 %, Context Mode −1 %, Headroom −2 %. Jednotlivé úlohy se rozcházejí oběma směry o jednotky až desítky procent, ale při třech bězích na buňku to od náhody neodliším. Za spolehlivý považuji jen směr, který se opakuje přes úlohy a má vysvětlitelnou příčinu. Tu podmínku splňuje jen Ponytail.
Co dělaly jednotlivé doplňky
Caveman zkrátil text. Účet zůstal stejný. Odpovědi byly o 3 až 26 % kratší, výstupní tokeny celkem ale ne (na třech úlohách ze čtyř jich bylo víc). Text odpovědí je kolem procenta ceny a pravidla Cavemana přitom přidají do začátku každé relace 3,8 tisíce tokenů. Na úloze s daty vyšel o 13 % dráž. JetBrains ve svém testu u něj naměřil −8,5 % výstupních tokenů a v součtu celého běhu o 11,6 % vyšší cenu. Sedí to.
RTK hlásí úspory, které na účtu nejsou. Na úloze s daty zachytil příkazy a sám si připsal úsporu 5,6 až 11 tisíc tokenů na běh. Cena ale vyšla o 5 % vyšší a objem výstupů v kontextu se nezmenšil. Důvody jsou dva. Agent si výstup testů filtruje sám (přes tail a grep) a velkou část kontextu tvoří čtení souborů vestavěným nástrojem, kterého se RTK vůbec netýká.
Context Mode agent ani jednou nepoužil. Nula volání jeho nástrojů ve dvanácti bězích, včetně úlohy se 40 MB dat. Instalace byla úplná a v prvních třech úlohách doplněk agenta v každém běhu 8 až 24krát navedl, ať jeho nástroje použije. Agent dal přednost vestavěným nástrojům, nejspíš proto, že na ně je trénovaný. Za to Context Mode přidal do začátku každé relace 14,5 tisíce tokenů, nejvíc ze všech. Na krátké opravě chyby vyšel o 24 % dráž, na ostatních třech úlohách naopak o 4 až 17 % levněji. Vysvětlení nabízí jeho vložený návod: zdá se, že agenta vedl k úspornější práci i bez vlastních nástrojů. Při třech bězích to ale od náhody neodliším.
Headroom si počítá úspory po svém. Podle vlastních statistik zkomprimoval 1,7 až 4 % tokenů požadavku a připsal si úsporu 6,5 až 26 % ceny. Naměřená změna je v průměru −2 %. Na předplatném smí jen bezztrátovou kompresi, a ta toho v agentní práci moc neušetří.
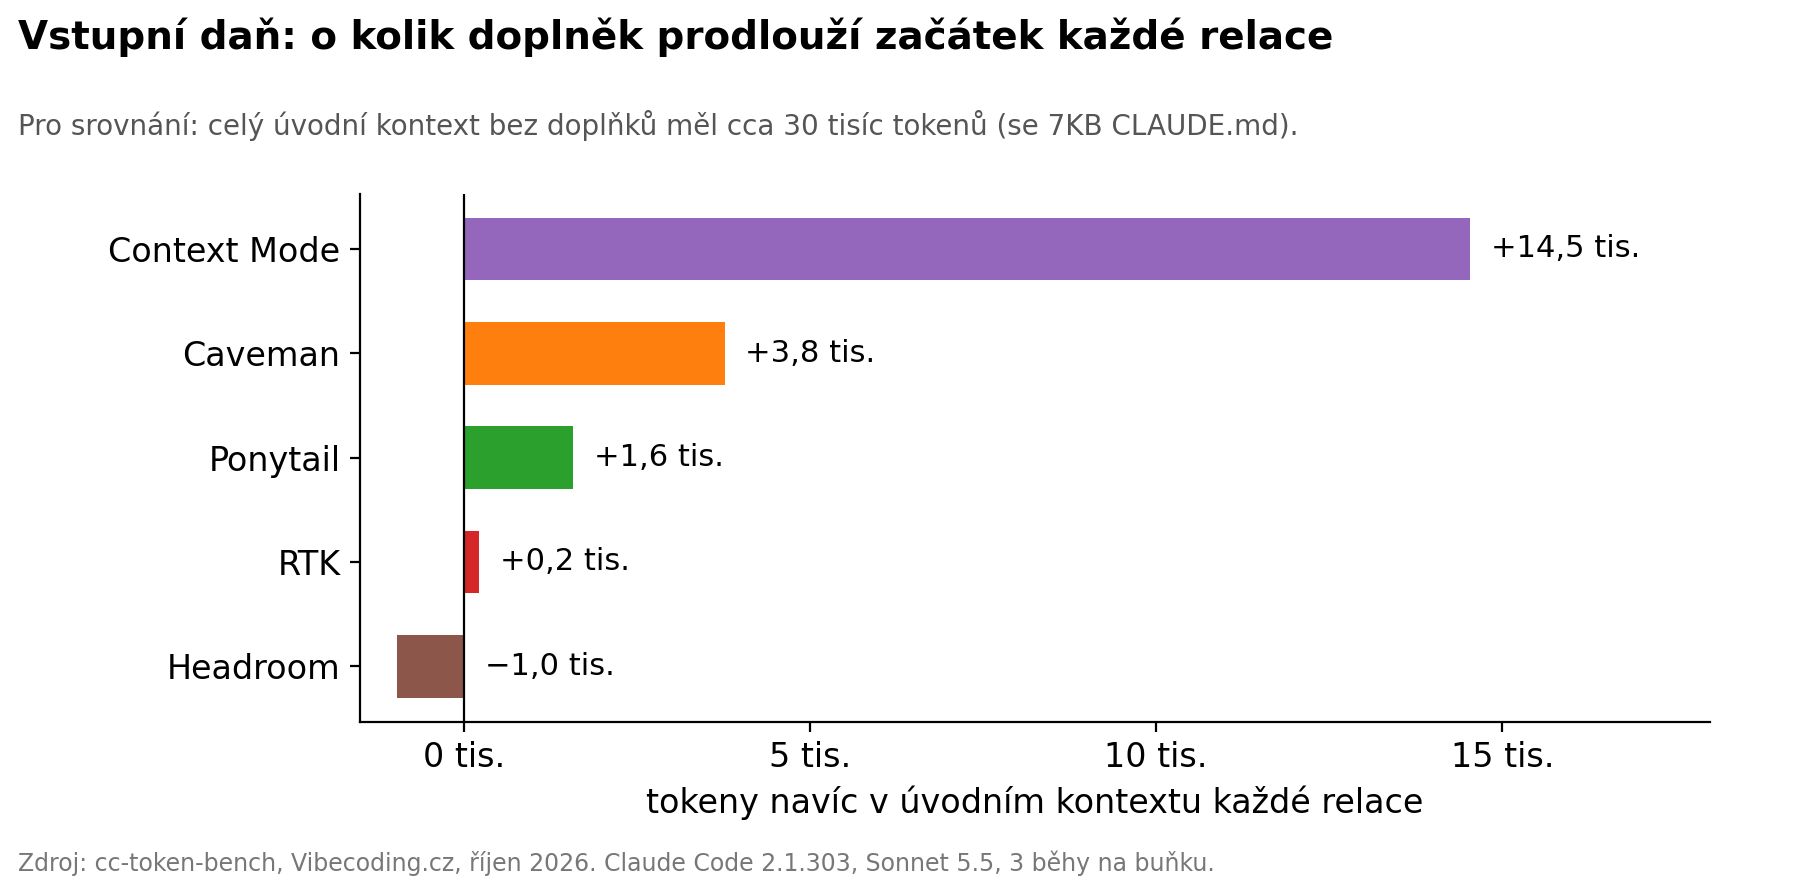
Context Mode, Caveman a Ponytail mají společnou vlastnost, kterou v jejich README nenajdete: vstupní daň. Každá relace s nimi začíná o 1,6 až 14,5 tisíce tokenů delší a ty se zapisují do cache za sazbu zápisu, čtyřicetkrát dražší než čtení. Pokud doplněk tuhle daň neodpracuje, prodražuje. RTK přidá jen pár set tokenů a Headroom začátek relace naopak mírně zkrátí.
A ještě jedna praktická rada: počítadlu doplňku nevěřte. RTK i Headroom hlásily úspory, které se v ceně neobjevily. Měřte cenu celé relace.
40 MB dat, a agent je přesto nepotřeboval číst
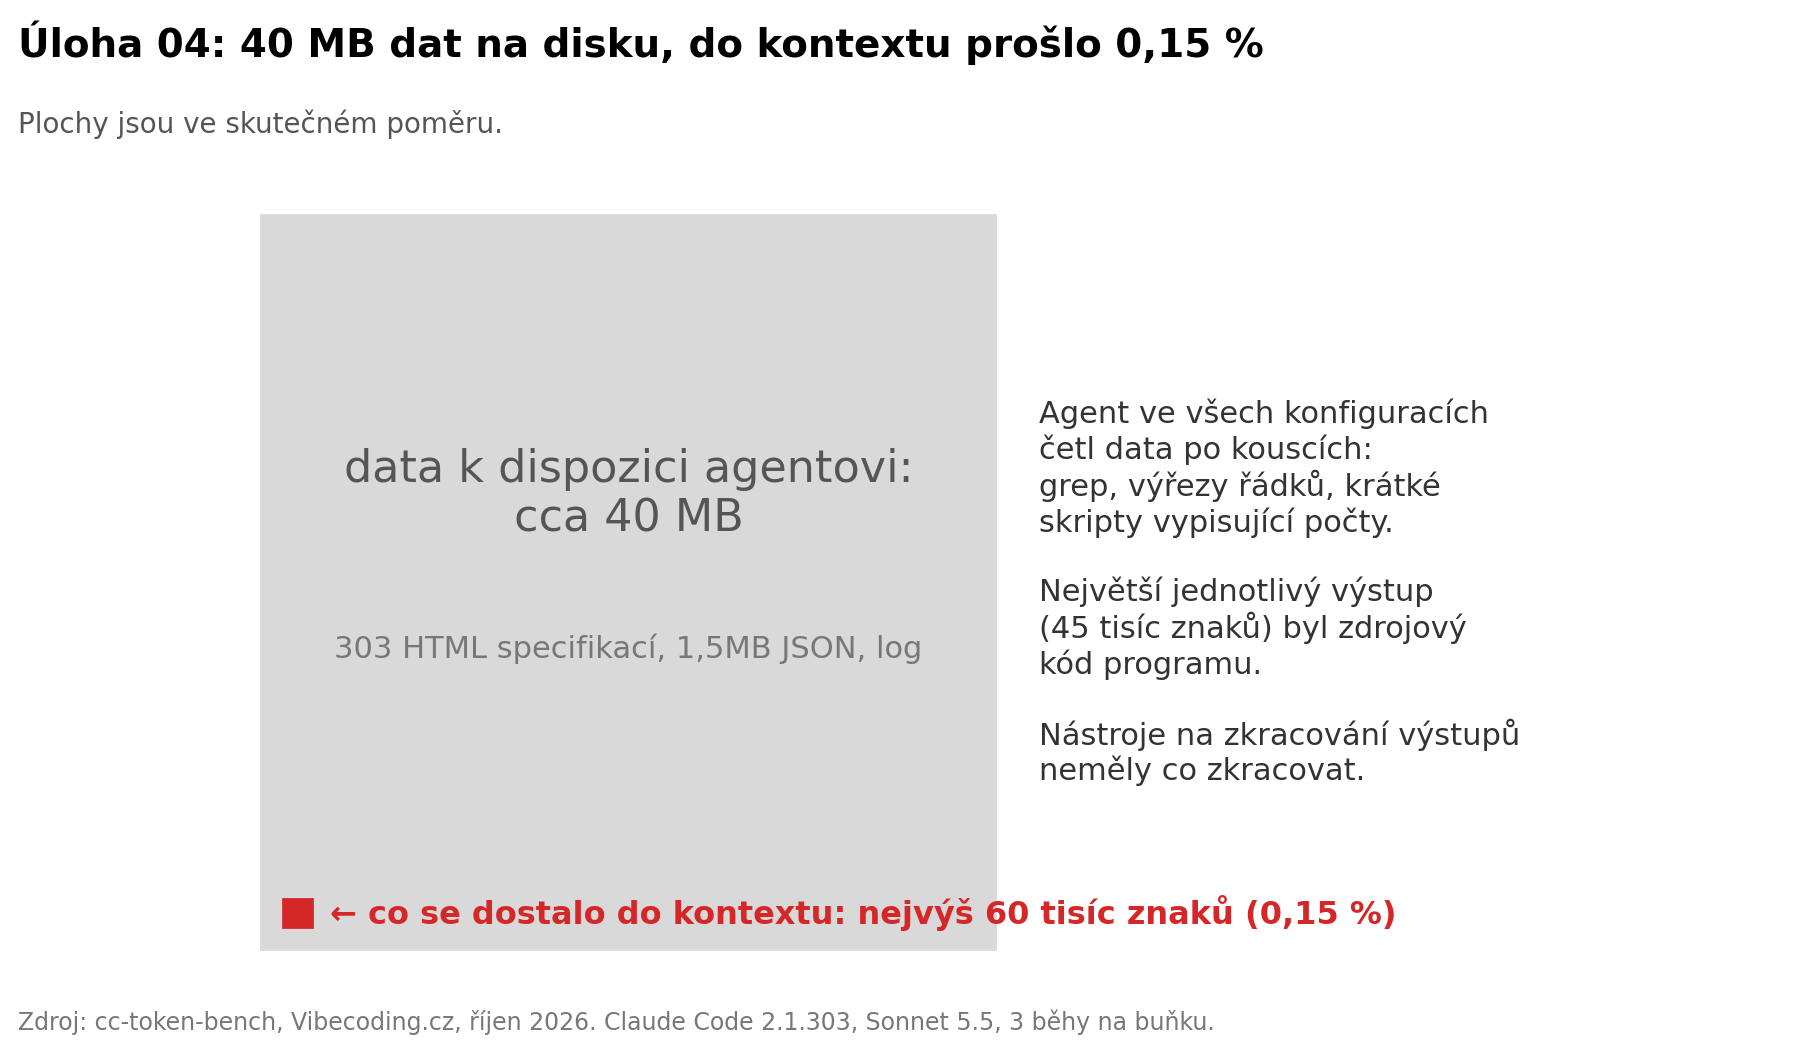
Úloha číslo 4 s velkými daty měla dát RTK, Context Mode a Headroomu šanci. Agent opravoval extrakci glosáře (slovníku výrazů v nových specifikacích mobilních sítí dle standardu 3GPP), která tiše ztrácela definice, a měl k dispozici 303 HTML specifikací, 1,5MB JSON výstup chybného běhu a jeho log. Bez práce s daty se příčina najít nedala.
Agent si data ve všech konfiguracích četl po kouscích: grep, výřezy řádků, krátké skripty vypisující počty. Do kontextu se ze 40 MB dostalo nejvýš 60 tisíc znaků. Největší jednotlivý výstup nástroje bylo přečtení zdrojového kódu programu. Žádný běh nenarazil na limit kontextu.
Doplňky na zkracování výstupů tak neměly co zkracovat, v mém testu si agent objemná data filtroval sám. (Mimochodem, agenti v datech našli i třetí skutečnou příčinu chyby, kterou původní oprava v projektu neřešila.)
Co jsem netestoval: výstupy, které agent filtrovat nemůže nebo nechce. Snímek stránky z prohlížeče, výpis pádu, dlouhý log testu, který potřebuje celý. Tam mohou RTK a Context Mode pomoct a jejich autoři mluví právě o takových případech.
Úspora, kterou máte ve vlastním CLAUDE.md
Při přípravě testu mi došlo, že projekt mezi výchozími commity úloh sám zeštíhlil CLAUDE.md. Výchozí stav první úlohy měl 67 KB, ostatní jen 7 KB. Pustil jsem proto stejné úlohy s vyměněným souborem.
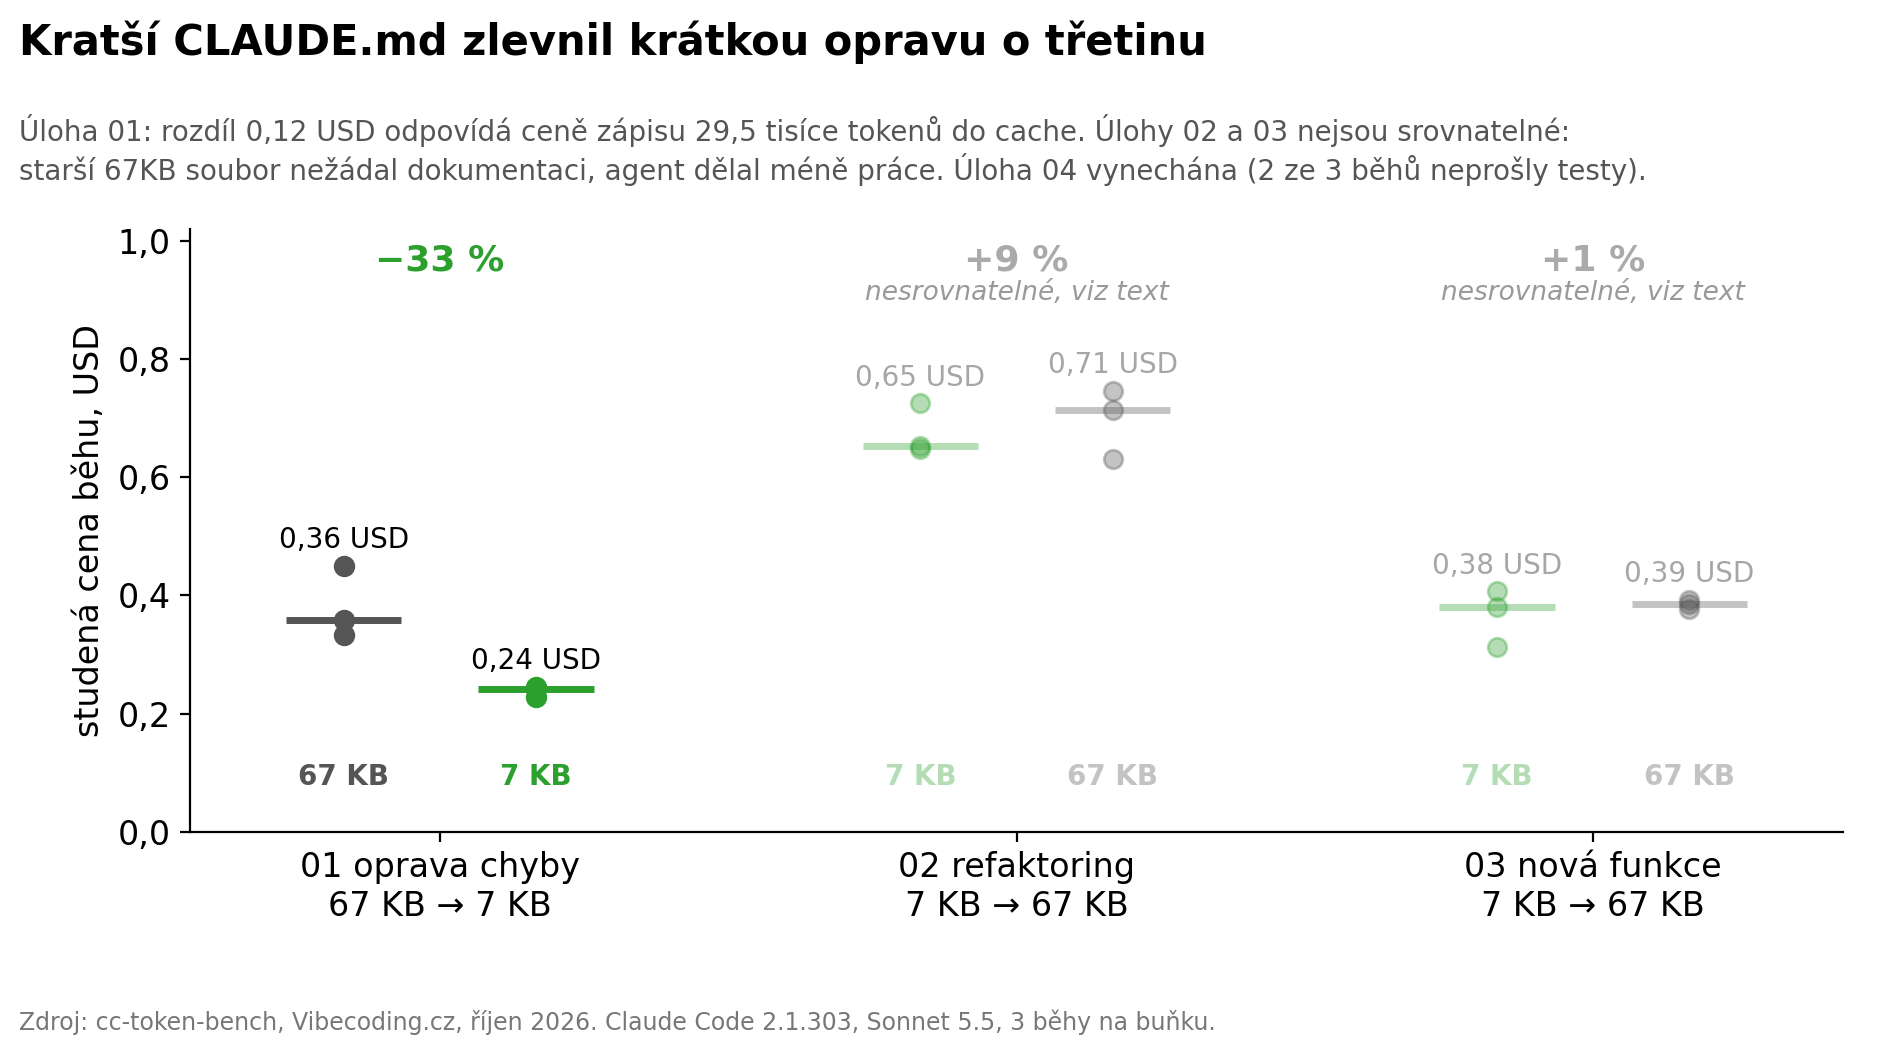
Krátká oprava chyby se 7KB CLAUDE.md zlevnila o třetinu, z 0,36 na 0,24 USD, a všechny tři běhy vyšly skoro stejně. To je víc než kterýkoli doplněk na téže úloze. A dá se to spočítat na cent: menší soubor zkrátil začátek relace o 29,5 tisíce tokenů, což je při zápisu do cache za 4 USD za milion právě 0,12 USD. Zpátky k příměru se stěhováním: tolik stálo naložit krabice, které agent k opravě nepotřeboval.
U refaktoringu a nové funkce jsem zkusil opačný směr, tedy 67KB soubor místo 7KB. Vyšlo +9 % a +1 %, jenže z těch čísel nic nevyčtete. Velký soubor zdražil zápis i čtení cache. Starší CLAUDE.md ale agenta nežádal o dokumentaci, takže agent udělal méně práce a napsal o čtvrtinu méně výstupu. Dva protichůdné vlivy se skoro vyrušily.
Co z toho plyne s jistotou: CLAUDE.md platíte při startu každé relace, u Sonnetu 5.5 zhruba 0,12 USD za každých 30 tisíc tokenů. Kdo pouští hodně krátkých úkolů nebo hodně paralelních agentů, platí to nakládání mnohokrát. Projděte ho a vyhoďte, co agent nepotřebuje u každé úlohy. Podrobnosti patří do samostatných souborů, na které CLAUDE.md jen odkáže.
Kvalita: levnější řešení může být i horší
Skryté testy prošly v 71 ze 72 běhů hlavního testu. První tři úlohy byly pro Sonnet 5.5 snadné a kvalitu mezi doplňky nerozlišily. Teprve úloha s daty ukázala rozdíly.
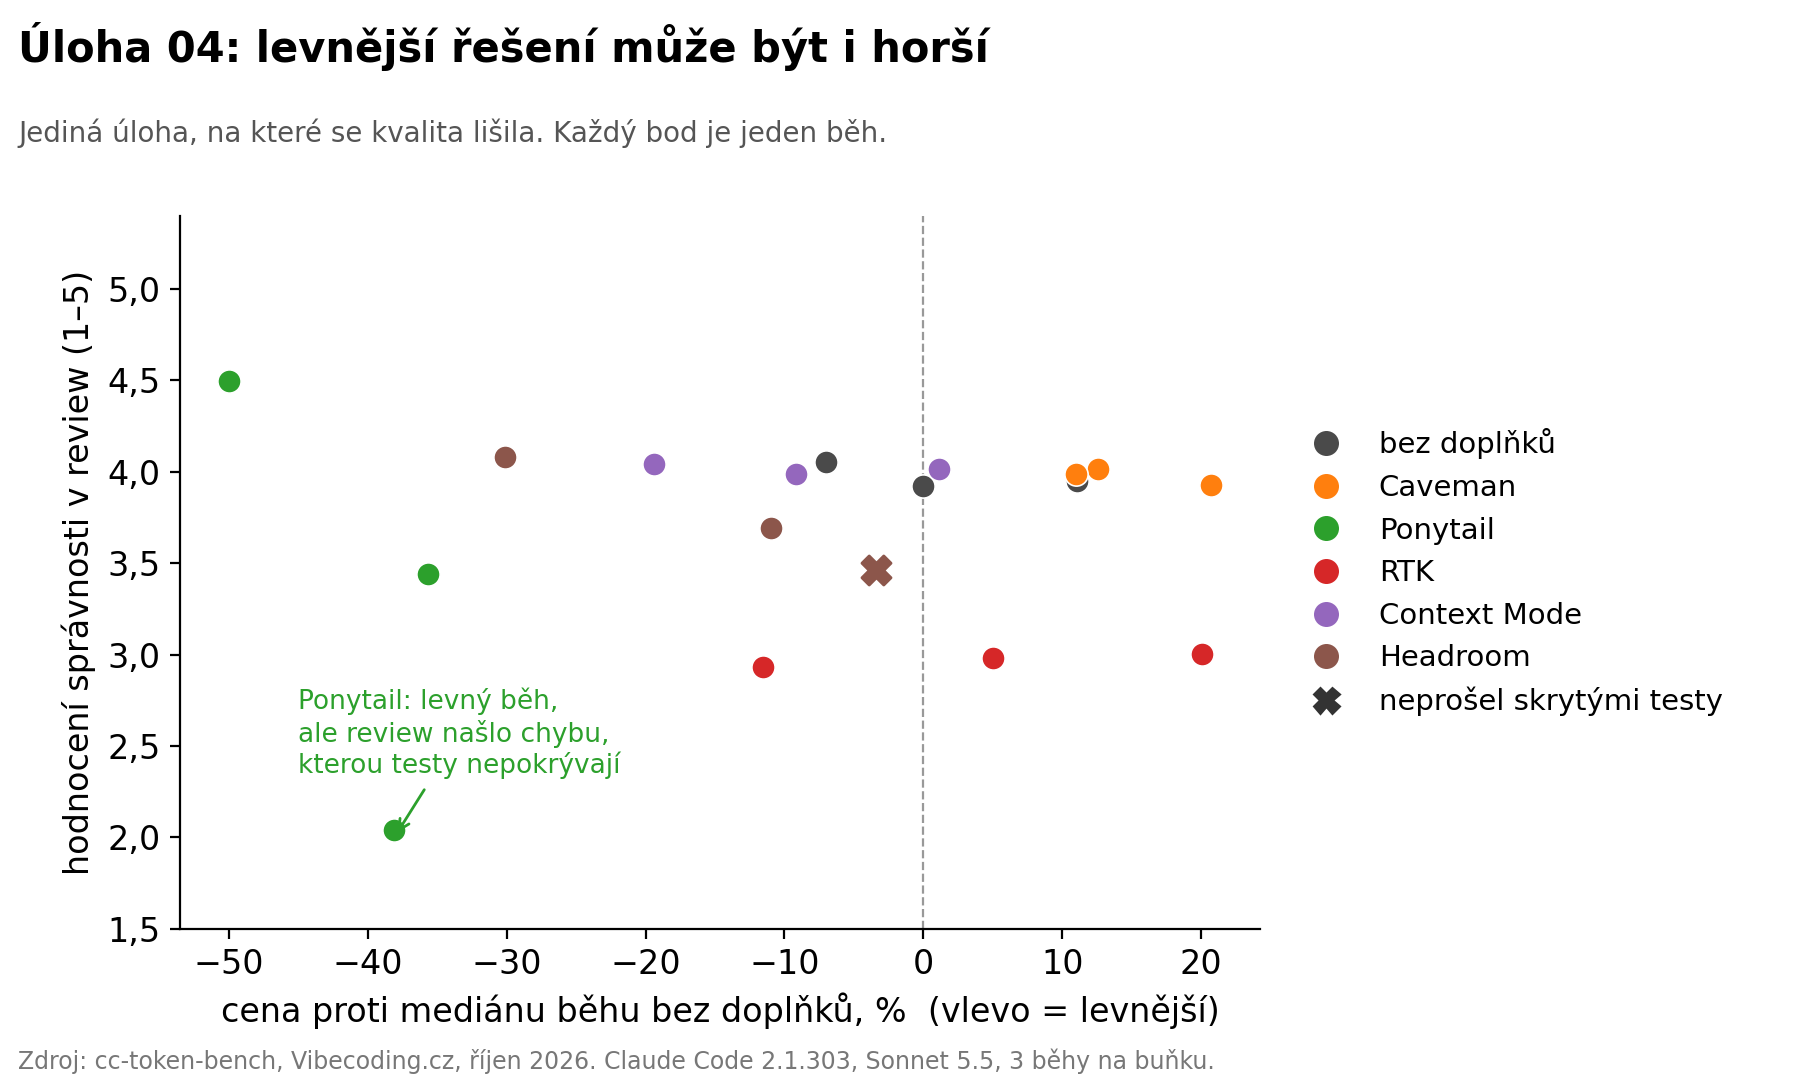
U Ponytailu našlo review v jednom běhu skutečnou chybu, kterou skryté testy nepokrývají: oprava v určitých případech přeskakovala sousední sekce definic. Testy prošly, podle review by ale výsledek v produkci ztrácel data (spuštěním jsem to neověřoval). Menší diff znamená i méně ošetřených okrajových případů. Ponytail vám ušetří, ale jeho kód si NUTNĚ přečtěte.
Jeden běh s Headroomem neprošel testy (do výstupu propustil šum), u RTK review opakovaně hodnotilo správnost hůř. Při třech bězích jde ale o příklady, žádné pořadí z toho nevyvozuji.
Jak měřit, aby to mělo smysl
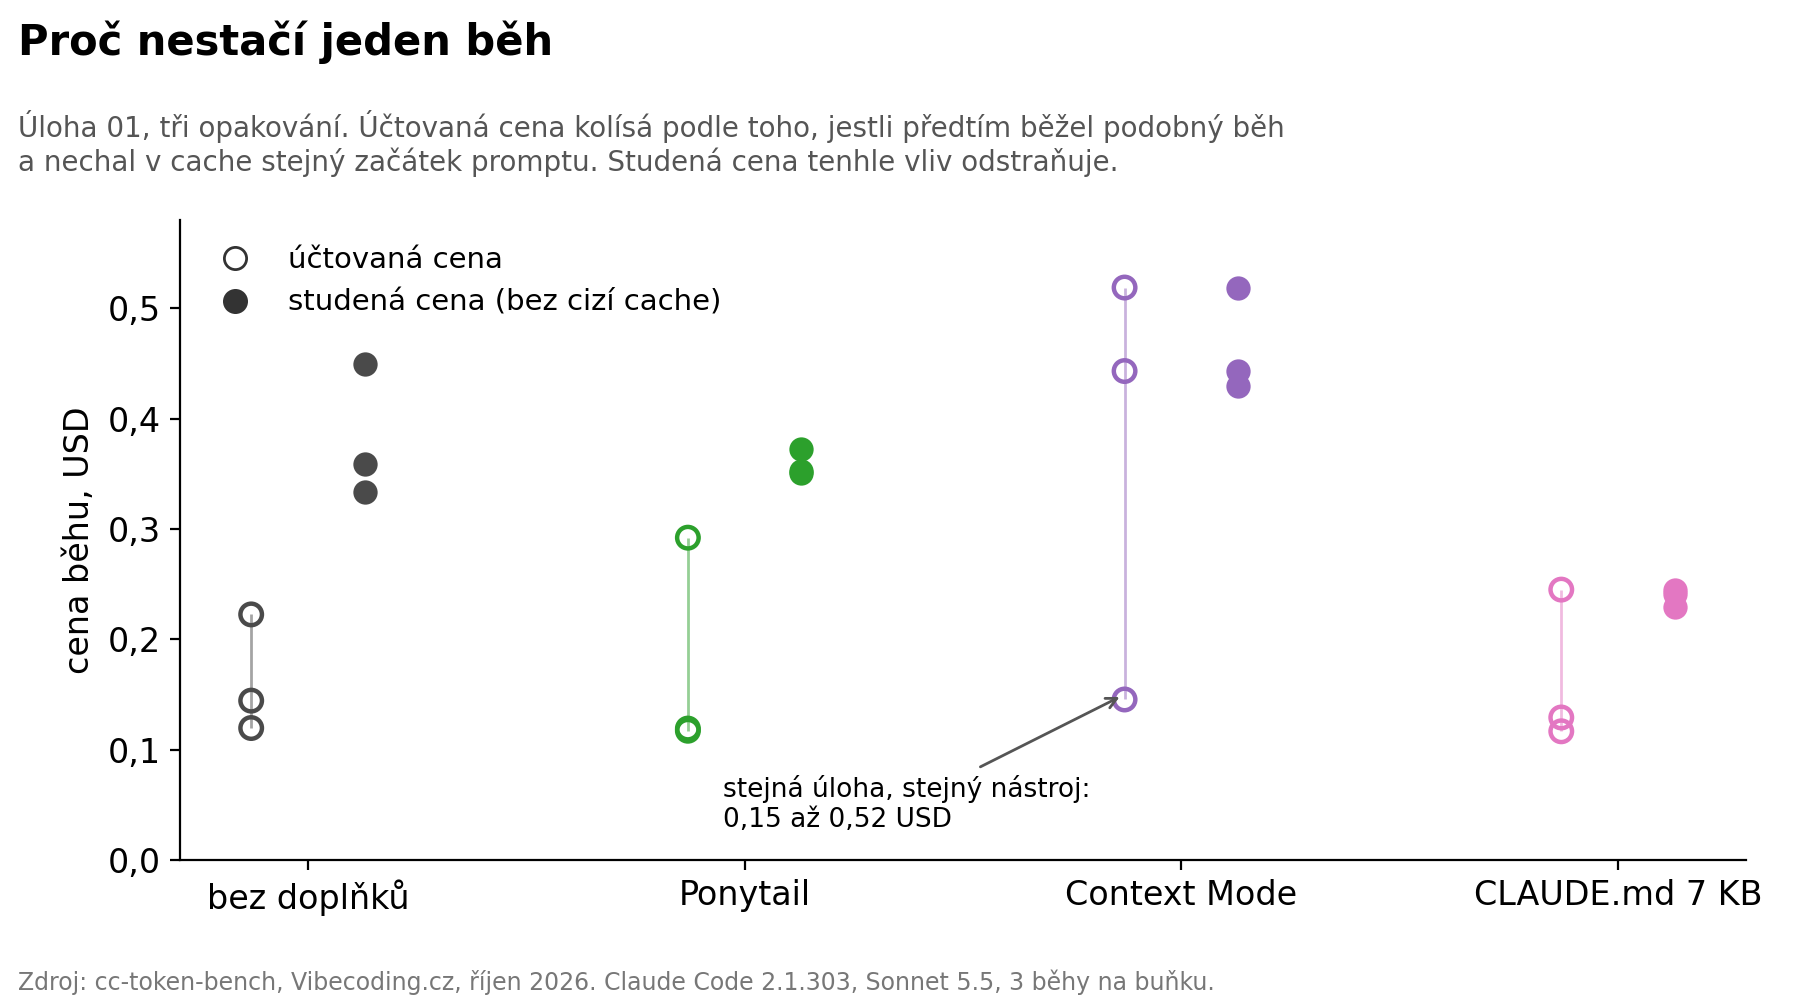
Při analýze jsem narazil na past, do které spadne každý, kdo si úsporu zkouší sám. Cache se sdílí mezi relacemi na stejném účtu a platí hodinu. Když před vaším během proběhl jiný se stejným začátkem promptu, první tah místo drahého zápisu levně čte. Stejná úloha se stejným doplňkem tak stála jednou 0,15 a podruhé 0,52 USD. Bez očištění by mi z dat vyšlo, že Context Mode zdražuje krátkou opravu o 207 %.
Srovnání proto dělám na „studené ceně“, jako by každý běh začínal s prázdnou cache. Odpovídá první relaci dne nebo práci s delšími pauzami. Pokud si doplněk zkoušíte sami, pusťte stejný úkol několikrát a s pauzou delší než hodinu, jinak měříte hlavně to, co běželo před vámi.
Hlavní omezení testu: tři běhy na kombinaci ukážou směr. Přesná procenta z nich nevyčtete. Jeden projekt, jeden model, neinteraktivní režim. Výsledky platí pro verze doplňků k říjnu 2026 a ty se mění po týdnech.
Pro předplatitele jedno užitečné měřítko: 54 nočních běhů v ceníkové hodnotě 18 USD posunulo můj pětihodinový limit zhruba o 8 procentních bodů a týdenní o jeden.
Co si z toho odnést
| Situace | Co dává smysl |
|---|---|
| Agent u vás píše hodně nového kódu | Ponytail, úspora kolem 20 %, výsledek si ale zkontrolujte |
| Hodně krátkých úkolů nebo paralelních agentů | zkrátit CLAUDE.md, v testu třetina ceny krátké opravy |
| Platíte předplatné a narážíte na limity | jen doplňky, které zkracují práci agenta; ostatní limity spíš čerpají |
| Pracujete s velkými soubory a logy | nejdřív změřit; agent si data filtruje sám |
| Výstupy, které agent filtrovat nemůže (prohlížeč, pády) | RTK nebo Context Mode stojí za vlastní test |
| Chcete kratší odpovědi | Caveman, ale kvůli čtení, účet neklesne |
Já bych si z testu nechal dvě věci. Ponytail, ale jen na úlohy, kde vzniká hodně nového kódu, a s pozornějším čtením jeho diffu. A pročištění vlastních CLAUDE.md souborů, protože tam je nejlevnější úspora ze všech a nemusíte kvůli ní nic instalovat.
Zbytek sestavy z úvodního příspěvku bych odinstaloval. Caveman a Context Mode platíte v každé relaci a na běžné práci se vám to nevrátí. Headroom sice začátek relace mírně zkrátí, měřitelně ale neušetřil a do cesty k API staví další proxy, která může selhat. Autor příspěvku na limit nejspíš zapomíná z jiných důvodů (tipoval bych velký tarif).
Příště: orchestrace agentů a více sessions. A rovnou varování: deset paralelních agentů znamená deset nakládání celého kontextu do cache. Úspora na tokenech to rozhodně nebude, otázka je, kolik za to dostanete rychlosti.
Zdroje a platnost: měření proběhlo 19.-20. října 2026 v Claude Code 2.1.303 se Sonnetem 5.5. Testované verze: Caveman 4.0.1, Ponytail 5.3.2, RTK 1.0.1, Context Mode 1.0.169, Headroom 0.41.0. Ceny podle oficiálního ceníku Anthropicu. Nezávislá měření: JetBrains, test Ponytailu a Cavemana. Harness, data a skripty: cc-token-bench. Doplňky se mění rychle, čísla berte jako stav k říjnu 2026.